
深色模式
第五章 模型识别与定阶
定阶是建模中最容易出错的一步。本章讲清 ACF/PACF 的局限、AIC 与 BIC 的目标差异,以及先筛后选的标准流程为什么必须按那个顺序。
5.1 ACF/PACF 定阶的局限
理论上 AR(p) 的 PACF 在 p 阶后截尾、MA(q) 的 ACF 在 q 阶后截尾。但实践中:
- 样本 ACF 有抽样误差,"截尾"在图上很少干净。
- 混合模型无法区分。ARMA(1,1) 和 ARMA(2,2) 的 ACF/PACF 形状可能非常接近。
- 季节性与结构变化会污染形状,制造假的"拖尾"。
- 接近单位根时,ACF 衰减极慢,看起来像非平稳,实际是 φ ≈ 0.98。
所以 ACF/PACF 的正确定位是:给出初始候选范围,而不是确定最终阶数。
打个比方:ACF/PACF 是体检初筛,不是确诊。初筛能把范围缩小到"疑似 AR 或疑似 MA",但具体几阶,还得靠后面的信息准则和样本外检验来定。把初筛当确诊,就会盯着图数柱子、硬凑阶数——这是初学者最常犯的错。
5.2 信息准则
三个最常用的准则:
AIC = −2 ln L + 2k
BIC = −2 ln L + k ln(n)
AICc = AIC + 2k(k+1)/(n − k − 1)
其中 L 是似然值,k 是参数个数,n 是样本量。另外还有 HQ = −2 ln L + 2k ln(ln n)。
惩罚强度:AIC < HQ < BIC(当 n ≥ 8 时 ln n > 2 > ln ln n)。
打个比方:信息准则就是考试分数减扣分。卷面分是 −2 ln L(拟合得越好,这一项越小、总分越高);但每多带一个参数就要扣分,防止你靠堆参数刷分。
三个准则的差别只在扣分力度:
- AIC 每加一个参数扣 2 分,扣得最轻,所以它偏爱"多带点人"。
- BIC 每加一个参数扣 ln(n) 分。样本 100 个时 ln(100) ≈ 4.6,比 AIC 狠一倍多——样本越大扣得越凶,所以它选出来的模型越简洁。
- HQ 卡在中间。
记住这个画面:AIC 是宽松的监考老师,BIC 是严格的。同一份答卷 AIC 给 85,BIC 可能只给 78,于是 BIC 倾向选那个更简单、更"干净"的模型。
目标不同:
- AIC 追求预测最优。它在渐近意义上等价于最小化与真实分布的 KL 距离,因此倾向于选稍大的模型——宁可多一个参数,也不愿漏掉真实结构。
- BIC 追求一致估计。当真实模型在候选集内时,BIC 选对真阶的概率随 n → ∞ 趋于 1。它惩罚更重,因此选出的模型更简洁。
★ 为什么 AIC 与 BIC 常常选出不同模型? 因为它们回答两个不同问题:AIC 问"哪个模型预测最好",BIC 问"哪个模型最可能是真的"。当 n 较大时 BIC 的惩罚 k ln n 远大于 AIC 的 2k,因此 BIC 更保守。这不是矛盾,而是目标差异。 写报告时应说明用的是哪个准则、为什么。
打个比方:AIC 像选一个最会考试的补习班——不管它教学理念对不对,能把分数提上去就行。BIC 像选一个最像真老师的补习班——要的是"这个班讲的东西就是真理本身"。
两者选得不一致,不是谁错了,是问的问题不同。做预测用 AIC;想解释机制、想说"真实过程就是它",用 BIC。报告里必须写明用了哪个、为什么——不写,答辩时一定被追着问。
★ AIC 比较的三条禁令:
- 不同 d 的模型不能直接比 AIC。因为差分改变了数据的变换,似然基于不同的样本(差分后少一个观测,且被解释的变量不同)。除非做修正(如纳入 Jacobian 项)。
- 不同样本量的模型不能比 AIC。样本变了,−2 ln L 的量级也变了。
- 不同变换的模型不能比 AIC(如原序列 vs 对数序列),除非做相应修正。
打个比方:这就像不能拿不同科目的分数直接比。语文 90 分和数学 90 分,含金量完全不同。差分了、换样本了、取对数了,都是"换了一张卷子"——卷子不同,分数线就不能通用。硬要比,得先把分换算到同一把尺子上(比如补上 Jacobian 项),否则比出来的大小毫无意义。
5.3 定阶的标准流程
一个可操作的流程(也是本项目采用的):
第一步:网格枚举。 设定 p、q 的范围(如 0–4 且 p+q ≤ 6),乘以是否含常数/漂移,构成候选集。范围不宜过大,否则多重比较问题严重。
第二步:收敛检查。 剔除优化器未收敛的候选。收敛失败通常意味着参数不可识别、初值差或模型过于复杂。
第三步:根检查。 剔除 AR 根不在单位圆外(非平稳)或 MA 根不在单位圆外(不可逆)的候选。
第四步:残差白噪声检查。 剔除残差 Ljung-Box 检验拒绝的候选。这一步保证模型已经把可预测结构提取干净。
第五步:样本外选优。 在验证集上比较预测误差(RMSE/MAE),选出最优。
第六步:tie-break。 若多个候选误差接近,按简约原则(参数更少优先)或次要指标(MAE)决出。
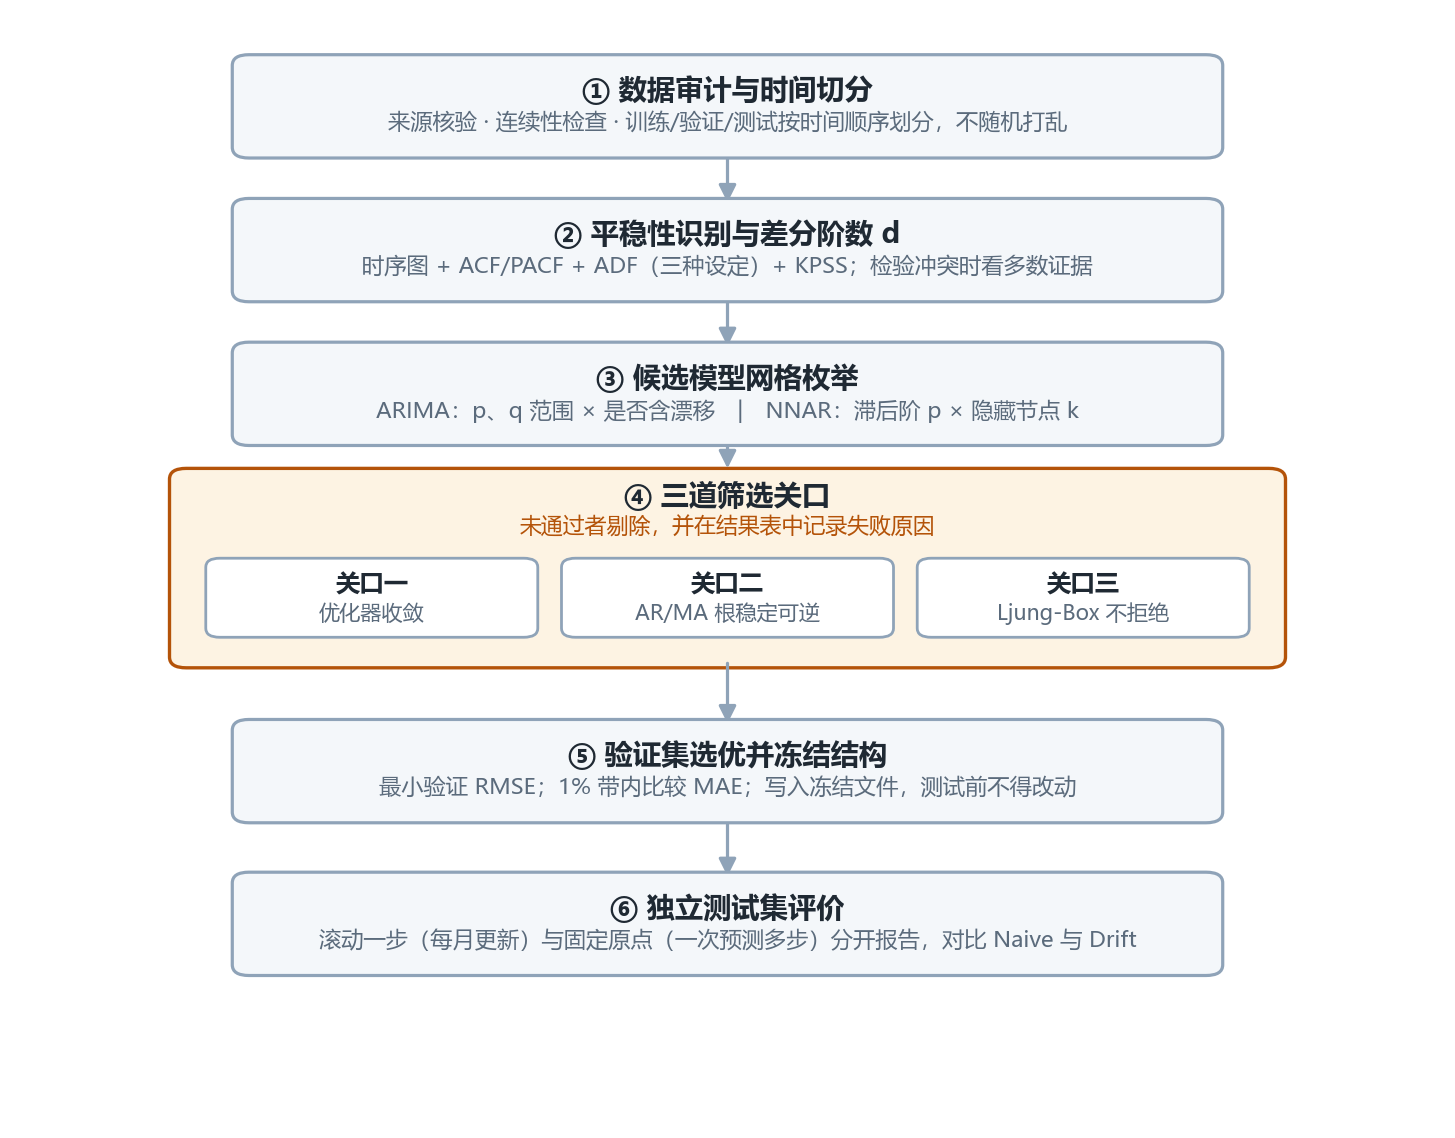
图 5-1 时间序列建模的标准流程(六步)
★ 为什么必须"先筛后选"? 因为前三步是硬约束(模型必须在数学上成立),后两步是软比较(在成立的模型里挑最好的)。如果直接按 AIC 排序取最小,可能选中一个不收敛或不可逆的模型,结论没有意义。
打个比方:这是招聘先过简历关,再面试。学历、证书这些硬条件不合格的,直接筛掉;不能因为某个人面试聊得特别好,就破格录用一个连资格证都没有的。前四步是资格审核(数学上必须成立),后两步才是面试打分(在合格的人里挑最好的)。
直接按 AIC 排序取最小,等于跳过资格审核直接面试——很可能选中一个优化器根本没收敛、或者 MA 根贴在单位圆上的模型,AIC 数字再漂亮也是废的。
5.4 过拟合检验
选定模型后,还应检验"再加一阶是否必要":
- 增加一个 AR 或 MA 项,看新系数的 t 值是否显著、AIC 是否下降。
- 若两者都不显著,说明原模型已充分。
- 若显著,说明原模型欠拟合,应升阶。
这就是逐步 ARMA 建模(stepwise ARMA)的思路:从低阶开始,逐步增加,直到新参数不显著。
打个比方:这是试衣服。穿上大一码明显松垮,说明原来那件刚好合身;如果大一码穿着也合适,说明你本来就该买大一号。加一阶之后新系数显著、AIC 还降了,就是"大一码也合身"——该升阶。
5.5 auto.arima 的机制与局限
R 的 forecast::auto.arima() 实现了 Hyndman-Khandakar 算法:
- 用 KPSS 检验确定差分阶数 d;
- 用季节强度指标确定 D;
- 在 (p, q, P, Q) 空间做逐步搜索,用 AICc 作为准则;
- 默认会尝试含/不含常数、含/不含漂移的变体。
局限:
- 逐步搜索可能陷入局部最优,不是全局最优;
- 默认不做严格的残差白噪声关口(只是"尽量");
- 对结构突变、异常值不稳健;
- 自动化程度高,容易让人跳过"为什么选这个模型"的思考。
★ 正确用法:把 auto.arima 的输出当作起点,再手工检查根、残差、样本外表现,不要直接接受。
打个比方:
auto.arima是自动挡汽车。它能把车开到目的地,但你可能说不清它为什么在这个路口换挡——一旦被问"为什么选 ARIMA(1,1,1) 而不是 (2,1,1)",你答不上来。更麻烦的是,它的默认设置不做严格的残差白噪声关口,等于绕过了一道安全检查。正确姿势:把它当副驾驶给的参考路线,自己再核一遍根、残差、样本外表现,然后决定走不走。
5.6 选模规则必须前置
这是一个方法论层面的要求,而不只是操作细节。
为什么? 因为一旦看过测试集结果,任何"事后调整规则"都会让测试集失去独立性——你会不自觉地选择让测试误差更小的规则,这就是信息泄漏。
怎么做? 把以下内容写进分析方案,并在执行前固定:
- 候选集的范围(p、q 上限);
- 通过关口的标准(收敛、根、白噪声检验的显著性水平);
- 选优指标(RMSE?MAE?);
- tie-break 规则(误差差多少算"接近",接近时比什么);
- 测试集的使用次数(一次)。
★ 一个容易被忽视的细节:tie-break 规则应当明确适用范围。如果规则写的是"RMSE 相对差异不超过 1% 时优先 MAE 更低者",那么它适用于所有模型族;若只想对某一族适用,必须写明。否则会出现"同一份报告里对 A 族用了规则、对 B 族没用"的自相矛盾。
5.7 训练、验证、测试的切分
时间序列不能随机划分,必须按时间顺序切分。常见的三种协议:
(1)一次性留出(hold-out)
前 70–80% 训练,中间 10–15% 验证(选模),最后 10–15% 测试(评价)。
- 优点:简单、清晰、测试集只被用一次。
- 缺点:只得到一个测试结果,方差大;且后期数据可能与前期的生成机制不同。
(2)滚动原点(rolling / walk-forward)
固定训练窗口或扩展窗口,每次向前滚动一个观测,重新估计并预测下一期。所有预测汇总后计算指标。
- 优点:模拟真实使用场景(不断获得新数据),样本点多,指标更稳定。
- 缺点:计算量大;需要明确窗口是固定长度还是扩展。
(3)时间序列交叉验证
把数据分成 k 个连续块,每次用前面的块训练、下一块验证。本质上与滚动原点同源。
★ 滚动一步 vs 固定原点:两种协议回答两个不同问题。
| 协议 | 做法 | 回答的问题 |
|---|---|---|
| 滚动一步 | 每月重估参数,只预测下一个月 | "如果能持续获得新数据,模型能预测多准?" |
| 固定原点 | 只在起点估一次参数,一次预测 h 步 | "如果一年不更新模型,误差如何累积?" |
两者不能混在一起算指标。把滚动预测和固定原点预测放进同一个 RMSE,等于把两种实验设计的数据混算,结果无法解释。
打个比方:这两个协议是两种不同的天气预报方式。
- 滚动一步:每天早上重新看一次云图,只报"明天"——回答"如果有最新数据,我能报多准"。
- 固定原点:1 月 1 日一口气报完全年 12 个月,中途不看新数据——回答"如果一年不更新,误差会滚到多大"。
显然,全年预报一定比逐日预报错得多。把两者的误差放进同一个平均值,等于把"一天的误差"和"一年的误差"混算,算出来的数谁也不是。
要点
- ACF/PACF 只能给初始候选,定阶要靠信息准则或样本外误差。
- AIC 追求预测最优,BIC 追求一致估计,惩罚强度 AIC < HQ < BIC。
- 不同 d、不同样本量、不同变换的模型不能直接比 AIC。
- 定阶顺序:网格 → 收敛 → 根 → 白噪声 → 验证集 → tie-break,硬约束在前。
- 选模规则必须写进方案并前置,tie-break 要明确适用范围。
- 滚动一步与固定原点回答不同问题,误差不可混算。
自测 3 问
Q1:AIC 和 BIC 的目标有什么不同?三种准则的惩罚强度怎么排?
点开看答案
- AIC 追求预测最优;
- BIC 追求一致估计(样本足够大时选中真实阶数)。
惩罚强度:AIC < HQ < BIC,所以 BIC 倾向选更小的模型。
Q2:哪些情况下两个模型不能直接比 AIC?
点开看答案
- 差分阶数 d 不同:似然基于不同的数据变换;
- 样本量不同:−2lnL 的量级随 n 变化;
- 数据变换不同(例如一个取了对数、一个没取)。
这些情况下 AIC 不可比。
Q3:ACF/PACF 在定阶里能起什么作用?完整的定阶顺序是什么?
点开看答案
ACF/PACF 只能给初始候选,真正定阶靠信息准则或样本外误差。
顺序:网格 → 收敛 → 根 → 白噪声 → 验证集 → tie-break,硬约束在前;选模规则要提前写进方案。